
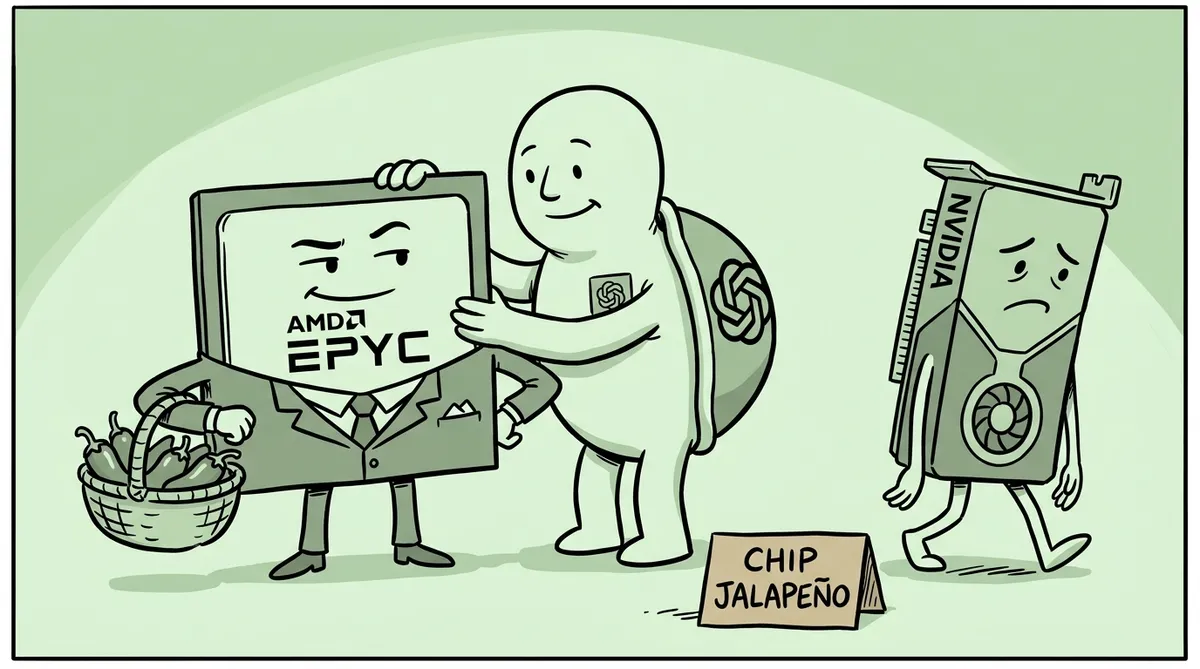
OpenAI desplegó su chip de inferencia Jalapeño en racks que usan procesadores AMD EPYC Turin como CPU anfitrionas, y no las Vera de Nvidia ni los chips Arm pensados para agentes de IA. Lo explicó Richard Ho, vicepresidente de hardware de la compañía. El ASIC pasó del diseño inicial a la fabricación en unos nueve meses, un plazo que suele estimarse en 18 a 24 meses en la industria.
Un ASIC es un chip diseñado para una sola tarea, aquí ejecutar modelos de IA ya entrenados, lo que se llama inferencia. En el sistema de OpenAI hace el trabajo pesado, mientras la CPU anfitriona gestiona y coordina todo lo que lo rodea. La empresa presenta el conjunto como un co-diseño de chip, memoria, red, software de despliegue y modelos, pensado para mejorar a la vez rendimiento, latencia, consumo de energía y costo.
Ho dijo que Vera estaba «un poco por detrás» en madurez
Según Ho, OpenAI evaluó varias alternativas y eligió EPYC Turin por su madurez. Los socios ya tenían experiencia con la plataforma y cumplía los requisitos del despliegue. Sobre Vera, usada como plataforma independiente, dijo que en el momento de la decisión estaba «un poco por detrás» de Jalapeño en nivel de madurez.
La evaluación es interna de OpenAI. No hay una medición pública e independiente que la respalde, y tampoco prueba que Vera rinda menos en términos generales. La elección no implica un alejamiento de Nvidia, cuyas plataformas la propia empresa reconoce como fundamentales para su expansión. Su infraestructura sigue combinando sistemas de Nvidia con componentes de AMD y de otros proveedores, entre ellos AWS, Broadcom, Cerebras, CoreWeave, Oracle, SB Energy y SoftBank. Broadcom participó además, junto con especialistas de OpenAI, en el desarrollo del ASIC.
Del diseño a la fabricación en nueve meses
Del diseño inicial al tape-out, el punto en que el diseño queda listo para mandarse a fabricar, pasaron aproximadamente nueve meses. OpenAI usó herramientas de IA para explorar opciones de diseño, verificar el chip, implementarlo y optimizar circuitos aritméticos. Los ingenieros humanos siguieron a cargo de las decisiones de arquitectura y la IA aceleró tareas puntuales.
La referencia de 18 a 24 meses es una estimación general de la industria, sin una auditoría independiente que la respalde.
OpenAI dice que Jalapeño supera a sistemas comerciales en InferenceX
La empresa presentó resultados de Jalapeño en InferenceX, un benchmark público que corre el modelo GPT-OSS 120B. Según OpenAI, el chip logró mayor rendimiento máximo por kilovatio y menor latencia por token que los sistemas comerciales con los que lo comparó, entre ellos los Nvidia GB200 y GB300.
Los datos finos no están publicados. Faltan la configuración exacta del hardware, el software utilizado, los límites de potencia y la metodología completa, así que la comparación no puede replicarse por fuera de la empresa. OpenAI también habría contrastado Jalapeño con plataformas Vera Rubin, con resultados favorables, pero esas cifras no se difundieron y no tienen verificación externa.
Jalapeño cubre primero la demanda interna de OpenAI
Ho indicó que OpenAI va a tener ocupación de sobra con sus propias necesidades de cómputo durante un largo período. No descartó del todo ofrecer el chip a otros clientes más adelante, pero no hay confirmación de que vaya a venderse a terceros.
Siguen sin conocerse la cantidad de chips desplegados, el número de racks o centros de datos, el modelo exacto de EPYC Turin, el consumo por chip o por rack, el costo de fabricación, las especificaciones de memoria e interconexión y los contratos con AMD y Broadcom. La fecha de un despliegue a gran escala tampoco se anunció.